Samenvatting
Kleine specialistische modellen verslaan grotere LLM-systemen op één taak, met zeven open modellen onder 10 miljard parameters.
Zeven specialistische modellen voor afzonderlijke taken
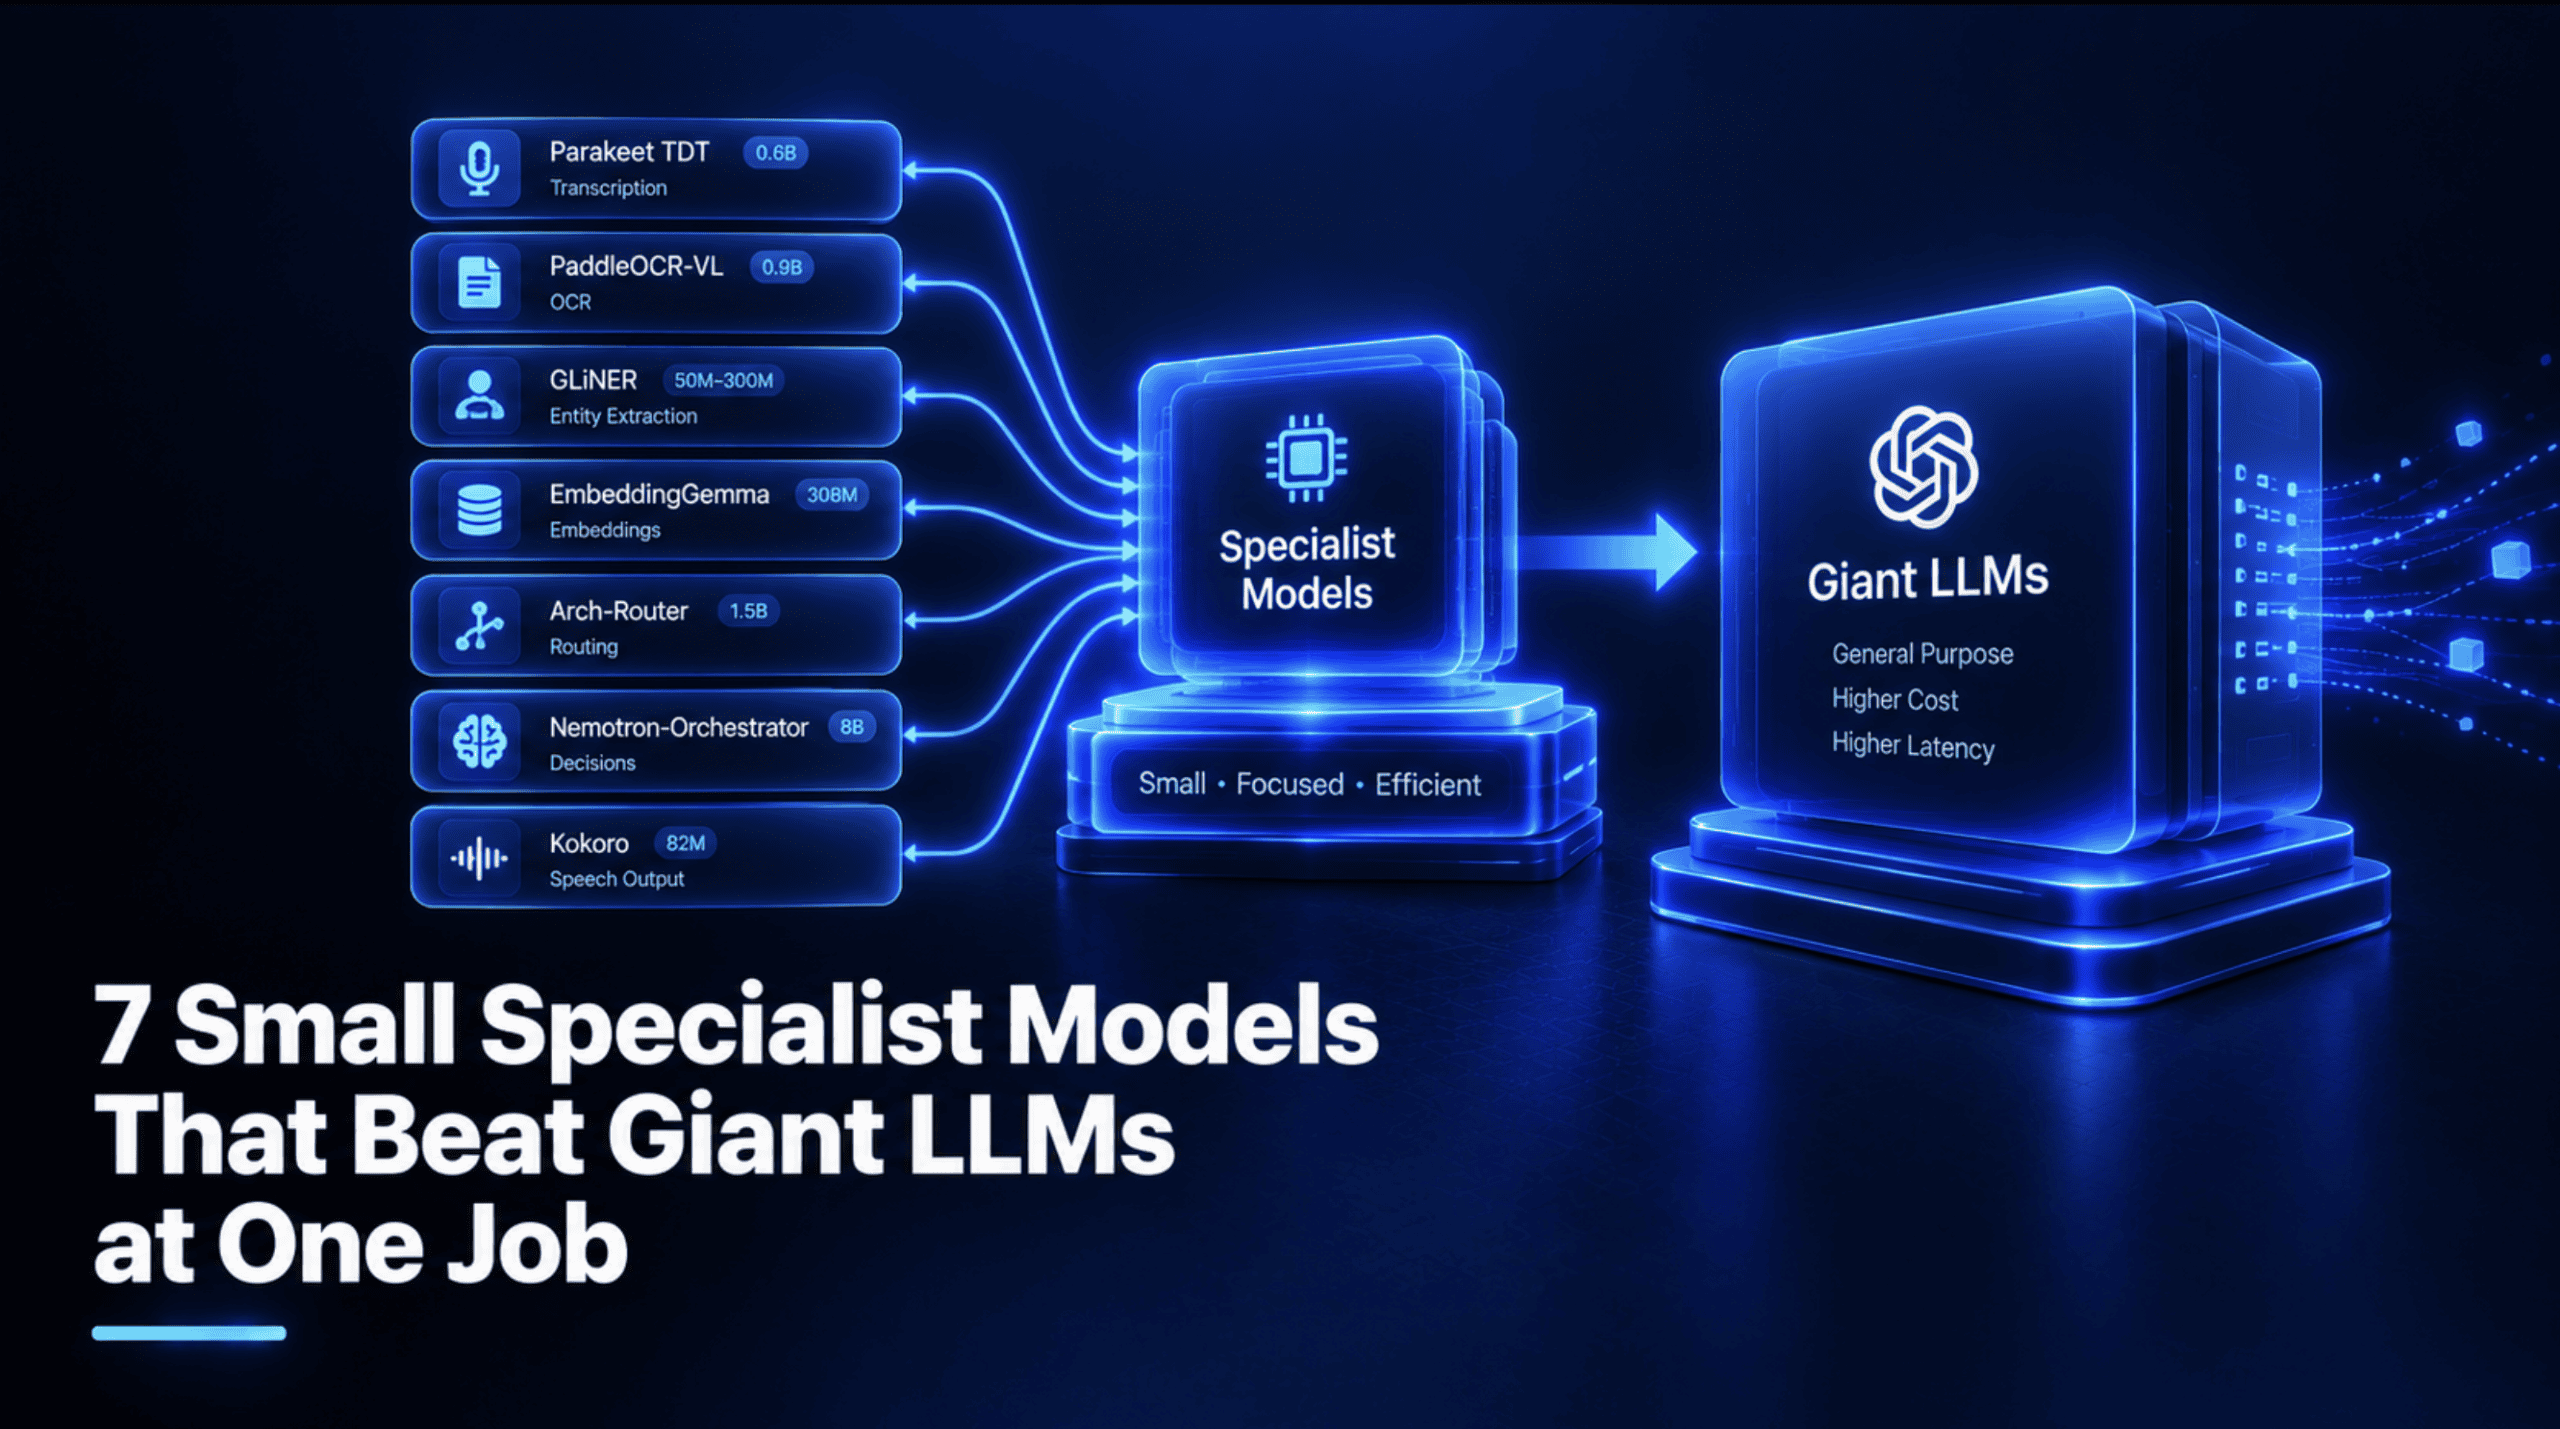
Het overzicht beschrijft zeven open modellen die elk één duidelijke taak uitvoeren en volgens gepubliceerde vergelijkingen grotere systemen evenaren of overtreffen. Alle modellen blijven onder 10 miljard parameters en zijn geselecteerd omdat ze op één machine kunnen draaien.
Parakeet TDT 0.6B v3 transcribeert sneller en nauwkeuriger dan Whisper large-v3. PaddleOCR-VL-1.6 met 0,9 miljard parameters verslaat Gemini 3 Pro en GPT-5.2 op OmniDocBench v1.6. GLiNER richt zich op named entity recognition, terwijl EmbeddingGemma embeddings maakt met 308 miljoen parameters.
De lijst bevat ook Arch-Router voor routering, Nemotron-Orchestrator-8B voor beslissingen en Kokoro-82M voor spraakuitvoer. De licenties verschillen per model: van Apache 2.0 en CC-BY-4.0 tot voorwaarden voor onderzoek of een gated modelpagina.
Specialistische modellen naast grote LLM-systemen
Een supportketen kan transcriptie, OCR, entiteitextractie, routering, besluitvorming en spraakuitvoer combineren. Een groot model kan al die stappen verwerken, maar het overzicht vergelijkt die aanpak met losse modellen die elk voor één taak zijn gebouwd.
De relevante alternatieven verschillen per toepassing. Parakeet wordt vergeleken met Whisper, PaddleOCR-VL met Gemini en GPT-5.2, Arch-Router met GPT-4o en Claude-Sonnet-3.7, en Nemotron-Orchestrator-8B met GPT-5. De bron stelt tegelijk dat specialistische modellen een groot LLM niet overal vervangen.
De keuze hangt daardoor niet alleen af van modelgrootte. Ook de gepubliceerde vergelijking, licentie, taakafbakening en lokale uitvoerbaarheid tellen mee. De installatie vraagt bovendien per model een aparte virtuele omgeving, omdat NeMo, Paddle en vLLM verschillende versies van PyTorch en bijbehorende bibliotheken gebruiken.
Concrete takeaway voor specialistische modellen
Breng eerst elke stap in je AI-pijplijn afzonderlijk in kaart. Vergelijk daarna het passende specialistische model met de baseline uit de bron, controleer de licentie en test de installatie in een eigen virtuele omgeving.
Let extra op uitzonderingen: EmbeddingGemma vereist een eenmalige Hugging Face-login en Kokoro heeft het systeempakket espeak-ng nodig. Zo voorkom je dat een modelkeuze strandt op toegang of afhankelijkheden.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
Vijf leuke artikelen die LLM's duidelijk uitleggen
Wetenschappelijke inzichten: vijf papers verduidelijken hoe LLM's werken.

Aanbevelingen: bronnen voor kleine taalmodellen
Aanbevelingen: bronnen voor kleine taalmodellen verduidelijken belangrijke vaardigheden voor data professionals.

AI: 5 kleine taalmodellen voor agenterend gebruik
Kleine taalmodellen verbeteren agentic AI-systemen door betrouwbare tool-aanroepen mogelijk te maken zonder hoge hardwar...

Vijf boeken voor beter begrip van grote taalmodellen
Wet TTA blijft gelden volgens KDnuggets voor AI & Analytics-specialisten.