Samenvatting
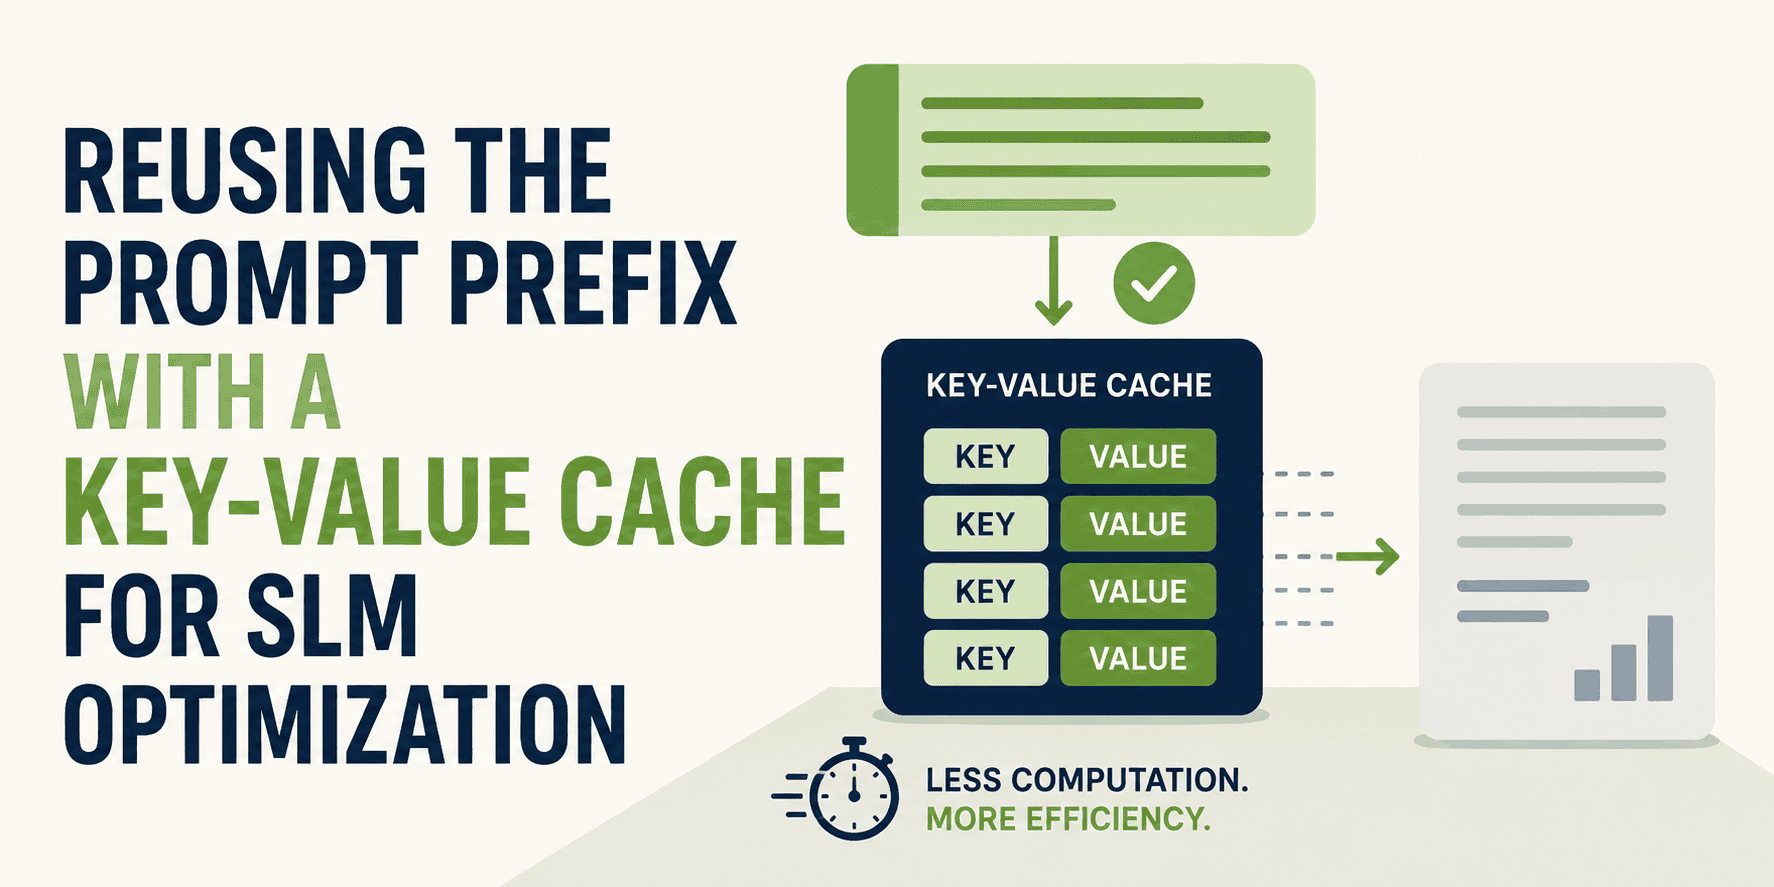
Key-Value Cache hergebruikt vaste promptdelen en verkleint zo de pre-fill per supportticket.
Prompt Prefix en Key-Value Cache: wat er gebeurt
KDnuggets bespreekt in het tweede artikel van een korte reeks hoe kleine taalmodellen vaste delen van een prompt opnieuw kunnen gebruiken. Bij narrow automation bestaan prompts vaak uit een taakomschrijving, taxonomie en enkele voorbeelden; alleen het laatste deel verandert per ticket.
Transformers berekenen voor elk token per laag een key- en value-vector. Omdat die vectors alleen afhangen van tokens die eerder in de prompt staan, blijven ze gelijk wanneer het promptprefix niet verandert. De implementatie berekent dit vaste deel één keer en bewaart de resultaten in een key-value cache. Per nieuw ticket hoeft vervolgens alleen het gewijzigde deel opnieuw door het model.
De vergelijking start met de baseline: een few-shot prompt wordt voor elk ticket volledig gecodeerd. De auteur gebruikt Qwen2.5-0.5B-Instruct in float16 via Hugging Face Transformers. De test draait op een M2 MacBook Air met 24 GB RAM en een 16-core Neural Engine, met 600 supporttickets verdeeld over de labels billing, technical en account.
Prompt Prefix en Key-Value Cache: waarom dit belangrijk is
De techniek richt zich niet op de classificatie-uitkomst zelf. De eerdere methode voor beperkte uitvoerruimte blijft actief, zodat de beslissing één forward pass vraagt. De nieuwe optimalisatie pakt het resterende werk vóór die berekening aan: het opnieuw verwerken van tokens die niet zijn veranderd.
Daarmee ontstaat een duidelijke keuze tussen volledige hercodering en prefixhergebruik. Die keuze is vooral meetbaar bij prompts met een lang vast instructieblok en een korte variabele invoer. De bron presenteert dit als een praktische SLM-techniek, niet als een wijziging aan het model zelf.
Prompt Prefix en Key-Value Cache: concrete takeaway
Test bij een repetitieve SLM-taak eerst hoeveel prompttokens identiek blijven. Splits daarna de prompt op een vaste grens, meet de baseline met volledige hercodering en vergelijk die met een key-value cache onder dezelfde model- en hardware-instellingen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Vijf strategieën voor promptoptimalisatie van LLM-output
Promptoptimalisatie verbetert LLM-output door bestaande prompts specifieker, gestructureerder en iteratief aan te scherp...

Resultaten ruimte beperken voor SLM optimalisatie
SLM optimalisatie: beperkte uitgifte ruimtetechniek verbetert automatisch processen.
De evolutie van Prompt Engineering naar Concept Engineering
De overgang van prompt engineering naar concept engineering biedt een duurzame aanpak voor AI-modellen in business intel...
De waarde van samenwerking met cybersecurityprofessionals (gesponsord)
Een sterke samenwerking met cybersecurityprofessionals is essentieel voor bedrijven die hun digitale strategie willen be...