Samenvatting
Databricks brengt on-demand state repartitioning voor Apache Spark uit, waarmee stateful streamingpartities zonder checkpointverlies worden aangepast.
On-demand state repartitioning voor Apache Spark: wat gebeurt er?
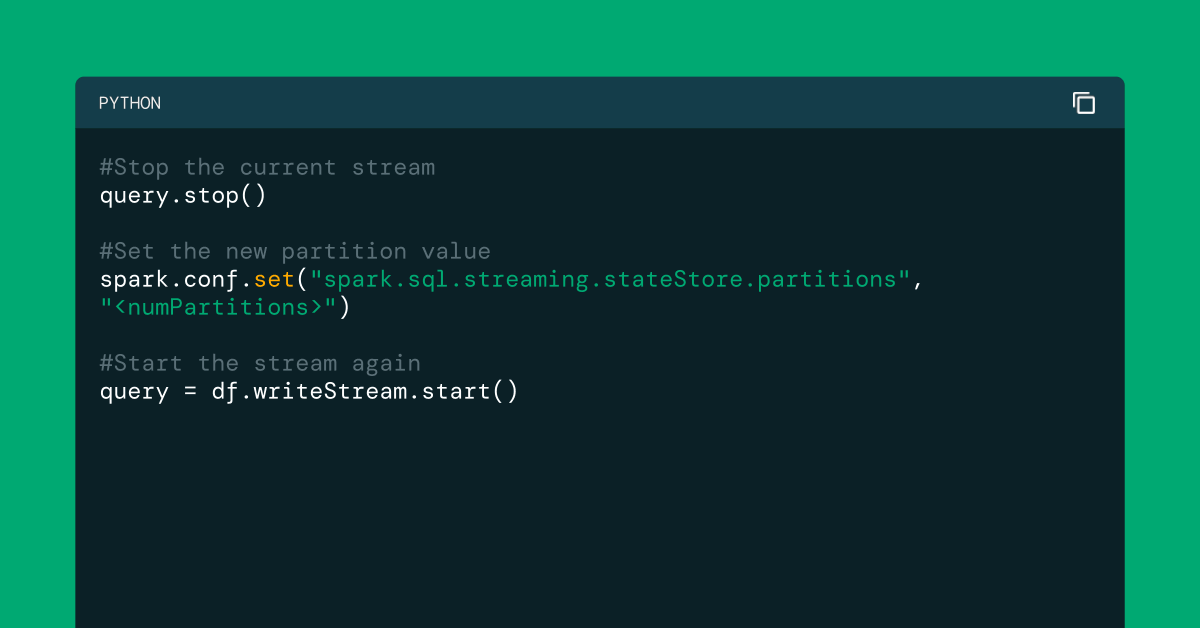
Databricks introduceert de functie als Public Preview in Databricks Runtime 18 en hoger. Met de configuratie `spark.sql.streaming.stateStore.partitions` kunnen teams het aantal partities wijzigen en daarna de streamingquery herstarten. De RocksDB state store verdeelt de bestaande state over het nieuwe aantal partities, terwijl het checkpoint behouden blijft.
De functie geldt voor stateful Apache Spark Structured Streaming, waaronder aggregaties, stream-stream joins, deduplicatie, sessionization en `transformWithState`. Query progress metrics laten zien wanneer een resize plaatsvindt.
Waarom on-demand state repartitioning belangrijk is
Bij een bestaande stateful query lag het partitieaantal vast in het checkpoint. Alleen `spark.sql.shuffle.partitions` aanpassen had daardoor geen effect. De klassieke oplossing was een nieuw checkpoint starten, maar daarmee ging de opgebouwde state verloren. Dat vormt een probleem voor toepassingen die fraudedetectie, accounts of sessies over langere perioden volgen.
Databricks verwijdert die operationele keuze tussen overprovisioning en opnieuw opbouwen. Coveo meldt dat het met State Repartitioning de gerelateerde Amazon S3 API-kosten met 40% heeft verlaagd. Volgens het bedrijf kwamen opslag-API-kosten eerder bijna op hetzelfde niveau als compute-kosten, omdat schaalbeslissingen checkpointmigraties konden veroorzaken.
De functie biedt geen algemene vervanging voor capaciteitsplanning: teams moeten nog steeds de partitie-instelling afstemmen op datavolume, scheef verdeelde partities en clusterbelasting. Wel blijft de bestaande state beschikbaar tijdens die aanpassing.
Concrete takeaway voor Apache Spark Structured Streaming
Controleer voor stateful streamingqueries of Databricks Runtime 18 of hoger en de RocksDB state store provider beschikbaar zijn. Plan daarna een gecontroleerde wijziging van `spark.sql.streaming.stateStore.partitions`, herstart de query en volg de query progress metrics om de nieuwe verdeling en de verwerkingstijd per microbatch te beoordelen.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
Gerelateerde artikelen

Beschikbaarheid van Real-Time Mode voor Apache Spark Structured Streaming op Databricks
Databricks heeft de algemene beschikbaarheid aangekondigd van de Real-Time Mode voor Apache Spark Structured Streaming.

Migreren van Apache Airflow® naar Databricks Lakeflow Jobs
De overstap van Apache Airflow naar Databricks Lakeflow Jobs vereenvoudigt data-orchestratie en verhoogt de efficiëntie ...

2026: De Uitdaging voor Startups op Databricks
Startups die innovatieve B2B-producten op Databricks ontwikkelen, krijgen de kans om in 2026 een prestigieuze uitdaging ...

Doorbraak van de Microbatch Barrière: De Architectuur van Apache Spark Real-Time Modus
Apache Spark heeft met de nieuwe real-time modus in versie 4.1 een grote stap gezet in datastromen en analytics.