Samenvatting
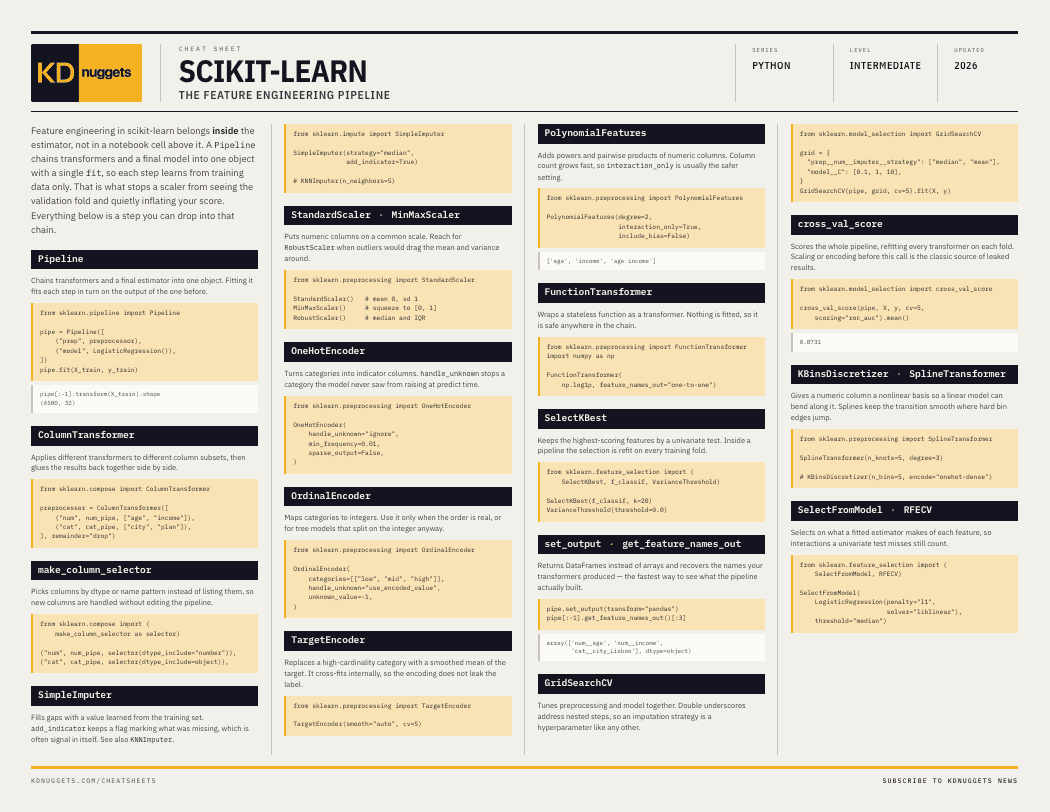
Scikit-Learn feature engineering krijgt van KDnuggets een cheat sheet voor preprocessing en modeltuning in Pipelines.
Scikit-Learn Pipelines bundelen feature engineering
De cheat sheet laat zien hoe preprocessing binnen een Pipeline hoort, zodat elke stap alleen trainingsdata ziet. Daarmee voorkom je dat informatie uit een validatiefold al vóór de modelschatting in de preprocessing terechtkomt. Een cross-validatiescore weerspiegelt dan beter wat het model werkelijk presteert op nieuwe data.
ColumnTransformer behandelt numerieke en categorische kolommen afzonderlijk. Met make_column_selector selecteer je kolommen op datatype, zodat een nieuwe kolom niet automatisch handmatige aanpassingen aan de pipeline vereist. SimpleImputer met add_indicator=True bewaart bovendien informatie over waar waarden ontbreken.
Voor categorische variabelen noemt de cheat sheet OneHotEncoder met handle_unknown=ignore. Die instelling voorkomt fouten wanneer een model tijdens voorspellingen een categorie ziet die niet in de trainingsdata stond. TargetEncoder past volgens de auteur beter bij categorische variabelen met een hoge cardinaliteit dan one-hot encoding.
Waarom Scikit-Learn Pipelines belangrijk zijn
De meerwaarde zit niet in losse transformers, maar in hun plaats binnen één reproduceerbare keten. Een notebook met handmatig geschaalde kolommen, apart gecodeerde categorieën en een later gefit model maakt datalekken makkelijk. Een Pipeline legt de volgorde vast en zorgt dat cross-validation dezelfde preprocessingregels per trainingsfold toepast.
Ook inspectie krijgt aandacht. Met set_output(transform=pandas) en get_feature_names_out() zie je welke kolommen de pipeline produceert. Dat helpt wanneer ColumnTransformer en PolynomialFeatures het aantal variabelen sterk uitbreiden. GridSearchCV kan vervolgens niet alleen regularisatie, maar ook imputatiestrategieën tegelijk afstellen.
Concrete takeaway voor Scikit-Learn
Zet schalen, imputeren, coderen en feature-uitbreiding voortaan in dezelfde Pipeline als de estimator. Gebruik daarna GridSearchCV voor preprocessingparameters en modelinstellingen, en controleer met get_feature_names_out() welke variabelen werkelijk uit de keten komen.
Verdiep je kennis
Kennisbank
ETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
KennisbankWat is Power BI? Alles wat je moet weten
Ontdek wat Microsoft Power BI is, hoe het werkt, wat het kost en waarom het de populairste BI-tool ter wereld is. Comple...
Gerelateerde artikelen
Scikit-LLM: handige cheat sheet voor estimators
Scikit-LLM koppelt taalmodellen aan scikit-learn, met ZeroShotGPTClassifier en GPTVectorizer voor herbruikbare pipelines...
Python: tijdreeksfunctie-engineering met Itertools
Power BI krijgt ondersteuning voor tijdreeksfeature-engineering met Python Itertools die BI-analyses verbetert.

De 2026 Data Science Starter Kit: Wat Eerst te Leren (En Wat te Negeren)
Nieuwkomers in data science krijgen met de 2026 Data Science Starter Kit handige richtlijnen over essentiële vaardighede...

5 GitHub-repositories om quantum machine learning te leren
Quantum machine learning krijgt vijf essentiële GitHub-repositories die leren versnellen.