Samenvatting
Python-scripts automatiseren CSV-verwerking met validatie, opschoning en transformaties via alleen de standaardbibliotheek.
Python-scripts voor CSV-verwerking
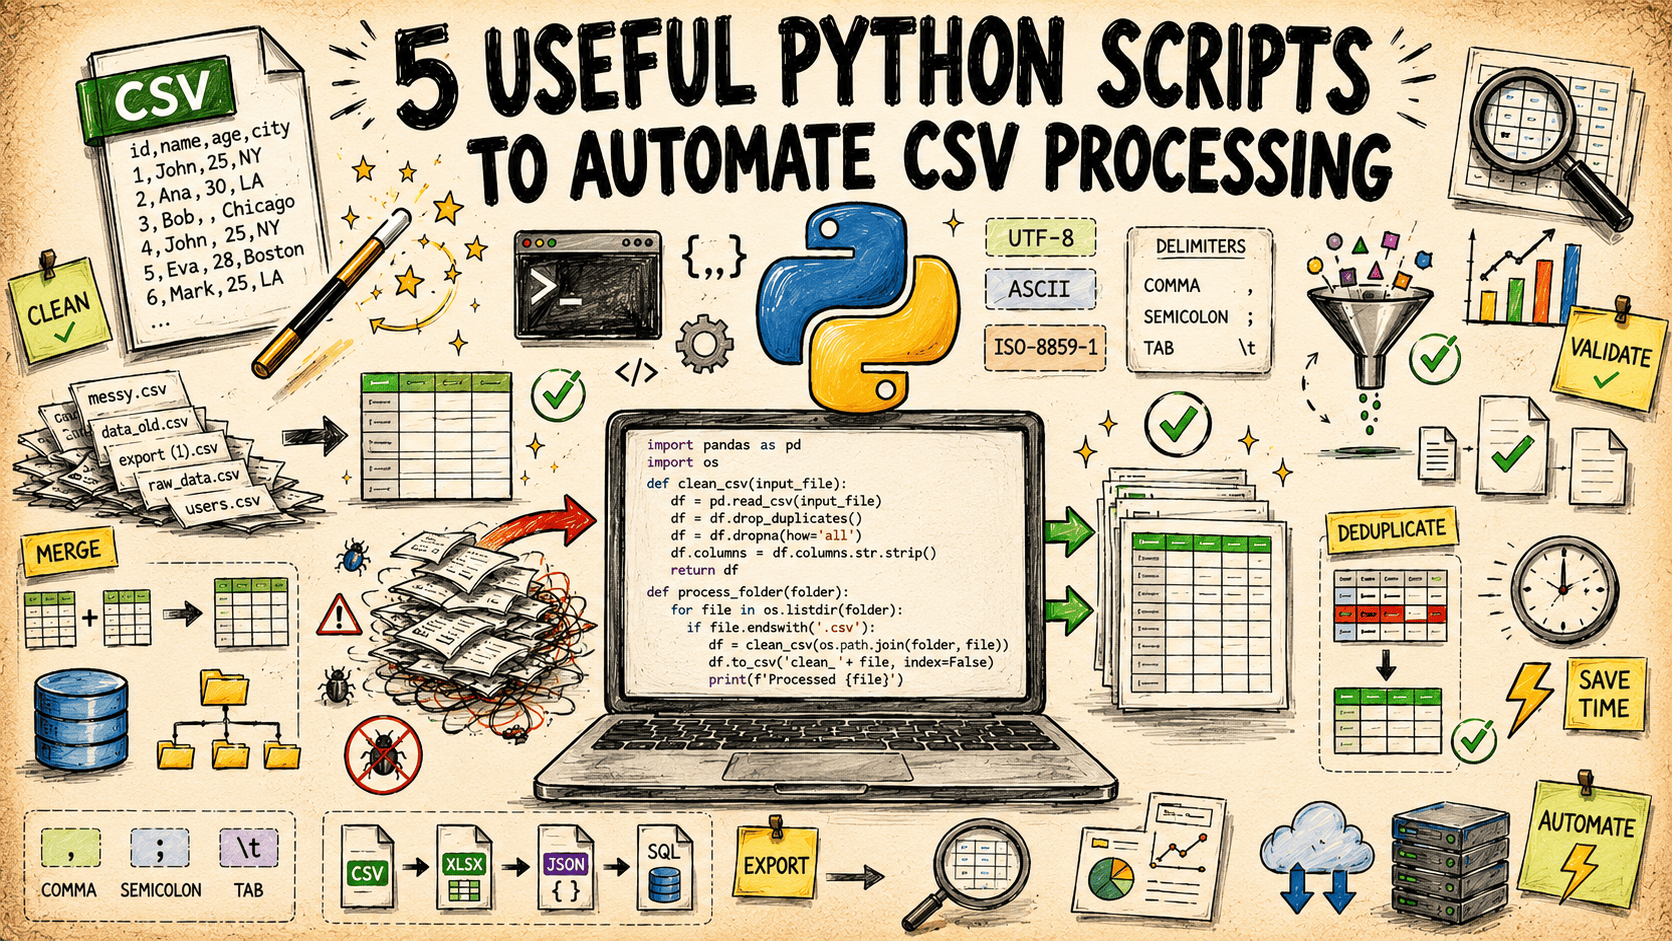
KDnuggets beschrijft vijf zelfstandige Python-scripts voor terugkerende CSV-taken. De scripts gebruiken uitsluitend de Python-standaardbibliotheek; extra pakketten installeren of afhankelijkheden beheren is daardoor niet nodig.
Het eerste script valideert een CSV-bestand tegen een schema in JSON. Het controleert verplichte kolommen, verwachte gegevenstypen en regels zoals niet-lege waarden of een patroon. Met csv.DictReader verwerkt het script rijen afzonderlijk en rapporteert het per fout de rij en kolom. Bij fouten geeft het een foutstatus terug, zodat een pipeline het bestand kan tegenhouden.
Het tweede script vergelijkt twee CSV-bestanden op basis van één sleutelkolom of een combinatie van kolommen. Het meldt toegevoegde, verwijderde en gewijzigde rijen en laat ongewijzigde rijen buiten de rapportage.
CSV-verwerking zonder extra pakketten
De voorbeelden richten zich op problemen die pas zichtbaar worden nadat een bestand een volgende stap bereikt: ontbrekende kolommen, onjuiste typen, lege waarden en wijzigingen tussen exports. Een spreadsheetcontrole kan zulke afwijkingen missen, zeker wanneer bestanden groter worden of dagelijks terugkeren.
De scripts plaatsen controles eerder in de keten. De schema-validator levert meer informatie dan een simpel geslaagd-of-mislukt resultaat en de rijvergelijking beperkt de uitvoer tot feitelijke verschillen. Dat maakt de voorbeelden bruikbaar als losse hulpprogramma’s of als kleine controles in bestaande Python-pipelines. De keuze voor de standaardbibliotheek houdt de uitvoering dicht bij de basisfunctionaliteit van Python.
Concrete takeaway voor Python-automatisering
Neem voor terugkerende CSV-aanleveringen eerst een schema-validator op als controlepunt. Gebruik daarnaast de row-level diff om nieuwe, verwijderde en gewijzigde rijen tussen exports zichtbaar te maken. Leg per bestand de sleutelkolommen en verwachte typen vast; zo krijgt elke fout een concrete locatie voordat de CSV verdergaat.
Verdiep je kennis
Kennisbank
ETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
Nuttige Python-scripts voor PDF-automatisering
Python-scripts automatiseren saaie PDF-taken met efficiënte en configureerbare oplossingen.
5 Python-scripts voor automatisering van saaie Excel-taken
Automatiseer saaie Excel-taken met deze vijf handige Python-scripts en verhoog je efficiëntie.
Vijf nuttige Python-scripts voor effectieve feature selectie
Met vijf praktische Python-scripts kunnen BI-professionals effectief feature selectie uitvoeren en hun datamodellen opti...

5 nuttige Python-scripts voor synthetische datageneratie
Gebruik maken van synthetische data met behulp van Python-scripts kan bedrijven helpen bij het trainen van AI-modellen z...