Samenvatting
Bodhan AI brengt vier modellen uit voor OCR, vertaling en spraak in Indiase talen.
Bodhan AI en de vier modellen: wat er gebeurt
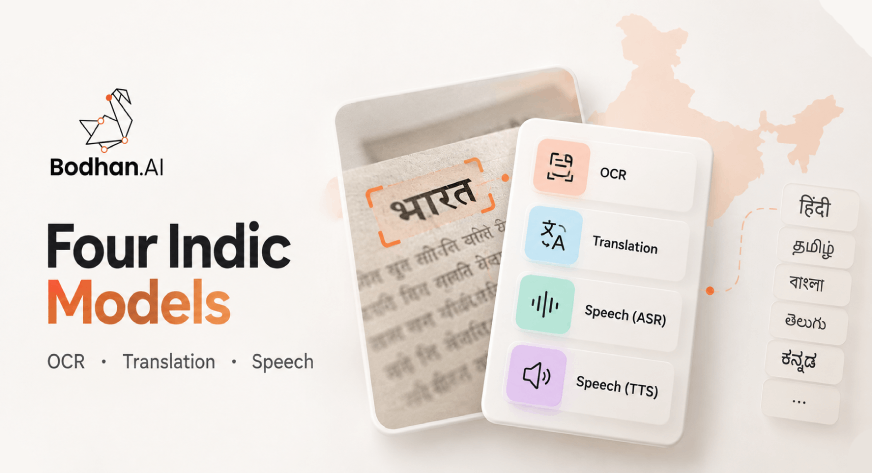
Bodhan AI en AI4Bharat publiceerden in september 2026 vier modellen voor documentverwerking, vertaling, spraakherkenning en spraakgeneratie. De modellen ondersteunen gemengde talen en schriften, zoals een Hindi-les met Engelse leenwoorden, gescande tabellen en handgeschreven vergelijkingen.
IndicOCR zet pagina-afbeeldingen om in gestructureerde tekst. IndicDocLayout, een model van 33 miljoen parameters, herkent paginablokken en leesvolgorde; IndicBlockOCR gebruikt Qwen3.5-0.8B en een Sarvam-tokenizer voor de tekstherkenning. Vergelijkingen worden LaTeX en tabellen behouden hun structuur. Het model verwerkt gedrukte documenten in het Engels en de 22 geplande Indiase talen, plus handschrift in het Engels en 12 Indiase talen.
Indic-Translate vertaalt volledige documenten en gebruikt een fine-tune van Gemma 4 E4B IT met 4 miljard effectieve parameters en een context van 32K. Indic-Transcribe biedt een Core- en Flexible-variant. Indic-Speak genereert spraak met 45 stemmen.
Waarom de vier Bodhan AI-modellen belangrijk zijn
De modellen behandelen een volledige keten: van pagina en tekst naar vertaling, transcriptie en gesproken output. Dat maakt het onderscheid met een losse OCR- of vertaaltool concreet. Mogelijke toepassingen die de bron noemt zijn het digitaliseren van studieboeken, het doorzoekbaar maken van regionale archieven en het voorbereiden van gescande pagina’s voor RAG.
De benchmarks vragen om een zorgvuldige lezing. IndicOCR behaalt 92,76 op OmniDocBench v1.6 en 82,20 op het Engelse olmOCR-Bench-subset. De interne IndicOCR-Printed-benchmark meldt 86,2 procent woordnauwkeurigheid over 22 Indiase talen en Engels. Die scores meten verschillende onderdelen; de Engelse documentparsing-score bewijst niet dat elke Indiase taal dezelfde nauwkeurigheid haalt.
Concrete takeaway voor Bodhan AI
Test elk model op je eigen documenten en taalcombinaties. Controleer bij IndicOCR afzonderlijk tekstherkenning, leesvolgorde, tabellen en handschrift, en baseer modelkeuzes niet op één benchmarkscore.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
AI vs Generative AI: Belangrijkste Verschillen, Modellen en Toepassingen
Generative AI is een essentieel onderdeel van AI en heeft verschillende toepassingen die BI-professionals niet kunnen ne...
LSTM-modellen: comprimeren voor retail edge toepassing
LSTM-modellen voor retail toepassingen worden gecomprimeerd voor efficiëntere implementatie in budgetvriendelijke omgevi...
AI: OpenAI API stemmodellen transformeren AI-gebruik
OpenAI krijgt nieuwe API stemmodellen die de manier waarop gebruikers AI toepassen transformeert.
PhysicEdit: beeldbewerkingsmodellen leren om natuurkunde te respecteren
PhysicEdit leert beeldbewerkingsmodellen om natuurkundige wetten te respecteren bij fysieke interacties in afbeeldingen.